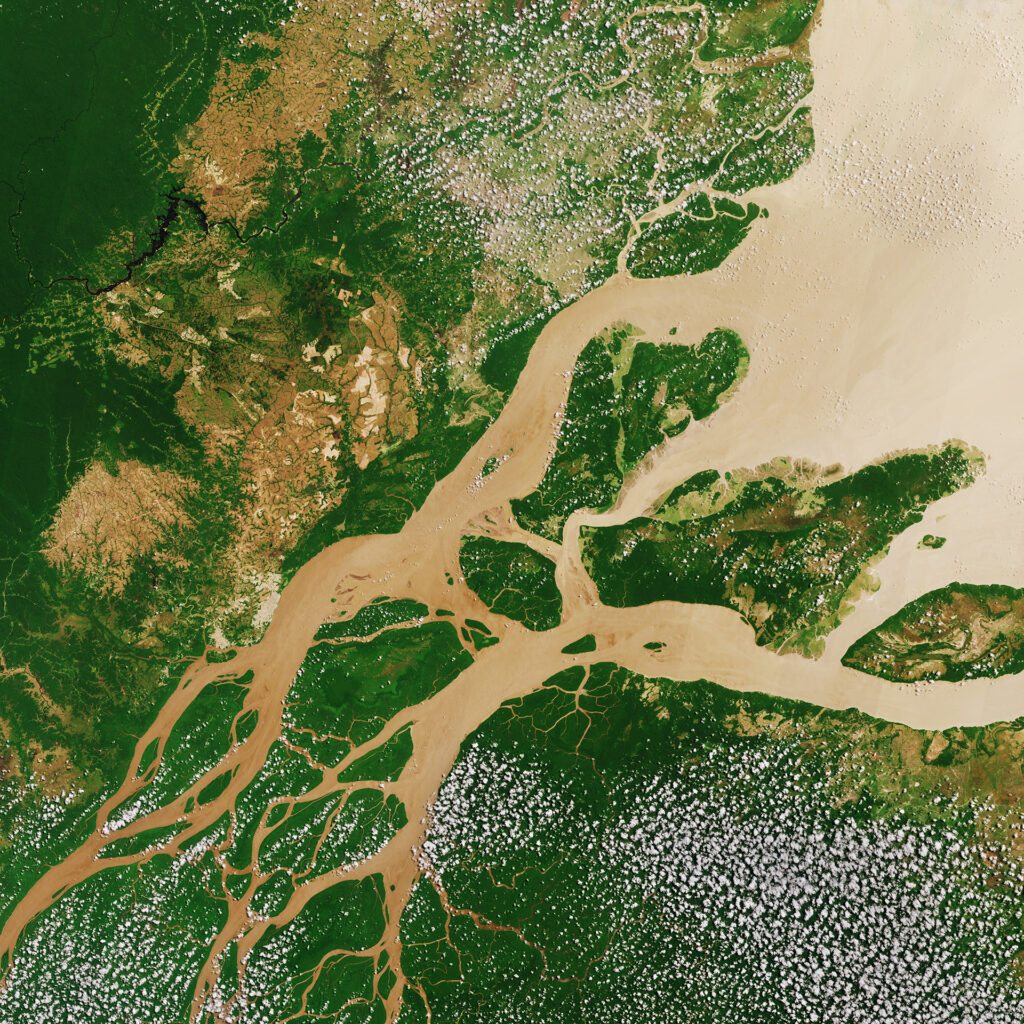
Por trás de quase todo modelo supervisionado que interpreta imagens de satélite, há um pequeno conjunto de imagens que alguém examinou de perto e rotulou manualmente. Em geral, são algumas centenas; às vezes, alguns milhares. Esse punhado é tudo o que o modelo conhece. A partir dele, o modelo aprende a distinguir lavouras alagadas de lavouras apenas encharcadas e um telhado em bom estado de um telhado comprometido.
Esse pequeno conjunto rotulado é minúsculo em comparação com o volume de imagens que de fato existe. Satélites fotografam o planeta em um cronograma fixo, então as imagens se acumulam continuamente, haja ou não necessidade, e a maioria nunca é usada. Rotulá-las é a parte lenta. É preciso um especialista treinado para dizer o que um determinado pixel realmente mostra, e mesmo um especialista consegue analisar apenas algumas cenas por dia.
Isso deixa duas carências distintas. A primeira é a falta de rótulos. Imagens são abundantes, mas pouquíssimas foram verificadas e rotuladas, então raramente sabemos com certeza o que cada uma mostra. A segunda é uma carência no próprio acervo. Ele contém apenas o que de fato aconteceu, registrado nos momentos em que um satélite passou por cima. Se você precisa de uma cena que nunca ocorreu, ou de uma que nenhum satélite capturou por acaso, o acervo não a tem.
Dados sintéticos de satélite ajudam com ambas as carências, de sete maneiras distintas. Cada uma permite que uma equipe tente um trabalho que, de outra forma, um pequeno conjunto de dados rotulados inviabilizaria.
Um modelo que interpreta uma cena de satélite precisa aprender várias propriedades da cena ao mesmo tempo: as formas dos objetos, as texturas que distinguem uma superfície de outra, o contexto espacial que torna a cena plausível e a resposta radiométrica do sensor que a registrou. Cenas geradas podem trazer as três primeiras em qualquer quantidade, tanto quanto o cronograma de treinamento exigir.
A abordagem usual é fazer o pré-treinamento com dados gerados e, em seguida, o ajuste fino com exemplos reais, para que cada fonte faça o que faz melhor. Os dados gerados ensinam a estrutura. Os dados reais vinculam o modelo ao sensor e ao local específicos. O conjunto real deixa de impor o teto do que a tarefa pode tentar; assim, um projeto que antes parecia exigir dois anos de anotação passa a ser uma execução de geração mais ajuste fino nas imagens que você já tem.
Muitas das previsões mais valiosas dizem respeito a eventos raros, como uma barragem sob estresse, uma enchente de recorrência secular ou vegetação crescendo até alcançar uma linha de energia e causar o desligamento. Cada um deles aparece no acervo apenas algumas vezes, espalhado por diferentes regiões, estações e sensores. Um modelo treinado nesse registro aprende as condições do dia a dia em grande detalhe e quase não vê as raras.
Com dados gerados, você decide com que frequência o evento raro aparece. É possível produzir essa classe deliberadamente, em todas as formas que ela assume, e na proporção do conjunto de treinamento que dê ao modelo uma chance justa de aprendê-la. A frequência passa a ser algo que você controla, e não algo que o acervo determina.
A maior parte do tempo e do dinheiro vai para a anotação manual, e o custo aumenta conforme a precisão exigida pela tarefa. Marcar onde a água está em uma cena de inundação já é trabalhoso. Traçar a borda exata de cada plano de telhado, ou o limite entre espécies em um povoamento misto, é ainda mais difícil, e o resultado é subjetivo, porque depende de como o anotador interpretou a cena.
Uma cena gerada já conhece o próprio conteúdo. Quem a construiu definiu as formas, os materiais de superfície, a extensão da água e a posição de cada objeto, então os rótulos existem antes da imagem e correspondem a ela com exatidão. Isso fornece máscaras em nível de pixel para tarefas em que a anotação manual seria impraticável. Ela ainda captura atributos que nenhum anotador conseguiria extrair de uma imagem, como a umidade do solo ou a altura real de um edifício.
Alguns dos dados de treinamento mais úteis vêm em pares correspondentes, e a observação real só consegue fornecer metade de cada par. Ensinar um modelo a enxergar através de nuvens significa mostrar o mesmo lugar no mesmo momento, tanto com nuvens quanto sem nuvens. Um detector de mudanças precisa de um antes e um depois que diferem em apenas um aspecto. Para avaliar um método de super-resolução, você quer a mesma cena em duas resoluções, sem mais nada ter mudado.
Um gerador produz as duas metades diretamente: ele renderiza a mesma cena duas vezes e altera apenas a variável que você quer. Nenhum outro método se compara a isso, e isso torna tarefas com pares correspondentes — como remoção de nuvens, detecção de mudanças e super-resolução — viáveis mesmo quando nenhum acervo real poderia fornecer os pares.
Dados rotulados de observação da Terra se concentram onde há financiamento. Existe anotação cuidadosa em quantidade para partes da América do Norte e da Europa, e apenas de forma esparsa em grande parte dos trópicos e do sul global. Um modelo treinado nesse registro herda o desequilíbrio. Ele aprendeu como se parecem um campo, um telhado ou uma estrada principalmente nos lugares que primeiro pagaram pelos rótulos.
É possível gerar cenas que correspondam ao bioma, às edificações, ao calendário agrícola e à atmosfera de onde o modelo de fato será executado. A cobertura passa a ser uma questão de escolher o que gerar. Isso importa mais justamente nos lugares onde os dados rotulados são mais escassos e onde os riscos ambientais são maiores.
Dados gerados são usados principalmente para treinar modelos. Eles são igualmente úteis para testá-los, e esse lado muitas vezes é negligenciado. Um conjunto de validação separado de imagens reais mostra como um modelo se sai nas condições que por acaso estavam na sua amostra. Um conjunto de teste gerado mostra como ele se sai nas condições específicas que você escolhe testar.
Isso importa mais quando um modelo alimenta uma decisão com dinheiro ou segurança em jogo. Ao variar névoa, ângulo do sol, estação, declividade do terreno e ruído do sensor em uma faixa controlada, você obtém um mapa de onde a precisão se mantém e onde começa a cair. Um relatório de validação pode incluir esse mapa, e um revisor ou um regulador pode agir com base nele.
Imagens de alta resolução vêm com termos de licença, e eles geralmente restringem a redistribuição. Equipes que trabalham entre organizações muitas vezes se veem incapazes de compartilhar o conjunto de dados por trás de um resultado, o que desacelera a colaboração e dificulta a reprodução independente.
Cenas geradas não têm esse tipo de restrição. Um benchmark baseado em dados sintéticos pode ser publicado integralmente, um parceiro pode executar a mesma avaliação com as mesmas entradas, e um fornecedor pode demonstrar um método em dados que o cliente é livre para manter e reutilizar. Em pesquisas em consórcio e em ambientes regulados, poder entregar os dados de fato é, muitas vezes, o que torna uma colaboração ou uma auditoria possível.
Ao longo desses sete usos, há um fio condutor. A quantidade de imagens rotuladas manualmente que uma equipe consegue reunir já não define o limite do que um modelo pode aprender. Dados gerados ampliam um conjunto pequeno até um tamanho utilizável, fornecem os eventos raros que um acervo real mal contém, chegam com rótulos exatos já anexados, produzem os pares correspondentes que a realidade não consegue, cobrem as regiões onde os rótulos reais são escassos, oferecem uma forma controlada de testar um modelo pronto e podem ser compartilhados sem restrições de licença.
A tendência é que os dados gerados se tornem uma parte padrão do pipeline de treinamento. A combinação de pré-treinamento em cenas geradas e ajuste fino em cenas reais é cada vez mais comum e, à medida que os dados gerados melhoram, o equilíbrio de que uma tarefa precisa se desloca ainda mais em direção a eles. Para quem constrói sobre dados de satélite, o resultado prático é que as tarefas antes engavetadas por falta de exemplos são as primeiras a serem retomadas.
A Another Earth gera dados sintéticos de observação da Terra em alta resolução, projetados para treinar e testar os modelos de IA usados em trabalhos ambientais, de infraestrutura e de clima. Nosso objetivo é ajudar organizações a passar de reagir ao que já aconteceu para antecipar o que vem a seguir, construindo a camada de dados preditivos para o mundo físico.