Junho foi um mês de conversas. Passamos por três eventos que reuniram públicos diferentes, mas todos orbitavam o mesmo futuro: Web Summit Rio, MundoGEO Connect em São Paulo e EO Summit em Londres. A energia em cada sala era única: rápida e cheia de fundadores no Rio, profundamente técnica e geoespacial em São Paulo, e com foco direto em observação da Terra em Londres. Três semanas muito interessantes, cheias de escuta, troca, aprendizado e muitas, muitas perguntas. De nós e para nós.
Dados sintéticos de satélite ainda são novidade para muitos, inclusive para algumas pessoas que trabalham com observação da Terra todos os dias, e há uma curiosidade genuína sobre o que são e onde se encaixam. Em vez de deixar essas respostas em conversas rápidas nos estandes, reunimos as cinco perguntas que mais nos fizeram e respondemos cada uma delas adequadamente abaixo.
O que são dados sintéticos de satélite?
Essa foi a primeira pergunta em quase todos os lugares e, em geral, a mais importante de acertar. A palavra “sintético” muitas vezes é recebida com certa desconfiança, por ser associada a algo falso, adulterado ou aleatório. Mas, na verdade, ocorre o oposto. Dados sintéticos de satélite são uma imagem criada de modo a ser física e estatisticamente fiel à imagem que um sensor real de satélite registraria sobre uma determinada cena. Trata-se de uma imagem de satélite criada artificialmente que não é apenas visualmente idêntica a uma imagem do mundo real, mas também produzida de forma que, até nos mínimos detalhes, mesmo um modelo de aprendizado de máquina altamente sofisticado a trate e aprenda com ela como faria com uma imagem capturada por satélite. O bônus: nós escolhemos as condições — e é exatamente aí que está o valor. Com isso, temos flexibilidade e liberdade para criar um conjunto de dados equilibrado, mas sem depender das condições do mundo real.
Em vez de esperar um satélite passar pelo lugar certo no momento certo, nós mesmos geramos a cena. A diferença em relação a uma imagem genérica de IA é igualmente importante. Não estamos produzindo algo que apenas pareça plausível ao olho humano. Estamos reproduzindo como luz, terreno, materiais e um sensor realmente interagem, para que o resultado se comporte como dado real quando um modelo aprende com ele.
A vantagem de gerar uma cena é que sabemos tudo sobre ela. Cada objeto, limite e tipo de superfície é conhecido porque nós o colocamos ali, o que significa que os rótulos vêm “de graça” e são exatos. Isso raramente é verdade em imagens reais. Assim, dados sintéticos são menos um substituto da realidade e mais uma forma de produzir realidade sob demanda, com verdade de terreno perfeita associada.
Por que usar dados sintéticos de satélite se já existem imagens reais?
Um questionamento razoável — e nós o ouvimos com frequência de pessoas que trabalham muito próximas de acervos reais. A resposta honesta é que imagens reais são abundantes nas proporções erradas. Há uma quantidade enorme de áreas agrícolas comuns, sem nuvens, em latitudes médias, e muito pouco das condições raras que os modelos mais precisam aprender.
Pense no que realmente importa operacionalmente: uma doença específica em uma cultura em estágio inicial, um tipo específico de embarcação no mar, uma enchente no seu pico, a frente de um incêndio florestal, um derramamento de óleo ou danos estruturais após um terremoto. Esses eventos são escassos no registro histórico. Quando aparecem, alguém ainda precisa encontrá-los e rotulá-los manualmente, o que é lento e caro — e a rotulagem humana introduz seus próprios erros.
Dados sintéticos nos permitem produzir, sob demanda, conjuntos de dados balanceados que incluem casos raros e difíceis, já rotulados com precisão. Podemos variar deliberadamente estação, iluminação, sensor e geografia, em vez de torcer para que o acervo contenha a diversidade de que precisamos. Nada disso substitui imagens reais. Os melhores resultados quase sempre vêm da combinação dos dois: usando dados reais para ancoragem e dados sintéticos para preencher as lacunas que eles não conseguem cobrir.
Como os dados sintéticos de satélite lidam com a cobertura de nuvens?
Lidamos com nuvens gerando-as nós mesmos, em vez de apenas removê-las — uma pequena inversão que nos dá algo que acervos reais quase nunca oferecem. Nuvens são um problema constante, e essa pergunta surgiu em todos os eventos. Em qualquer momento, aproximadamente dois terços do planeta estão sob nuvens, de modo que uma grande parcela das imagens ópticas de satélite fica parcial ou totalmente obscurecida. Para quem depende de uma visão clara do solo, isso é um problema persistente e caro.
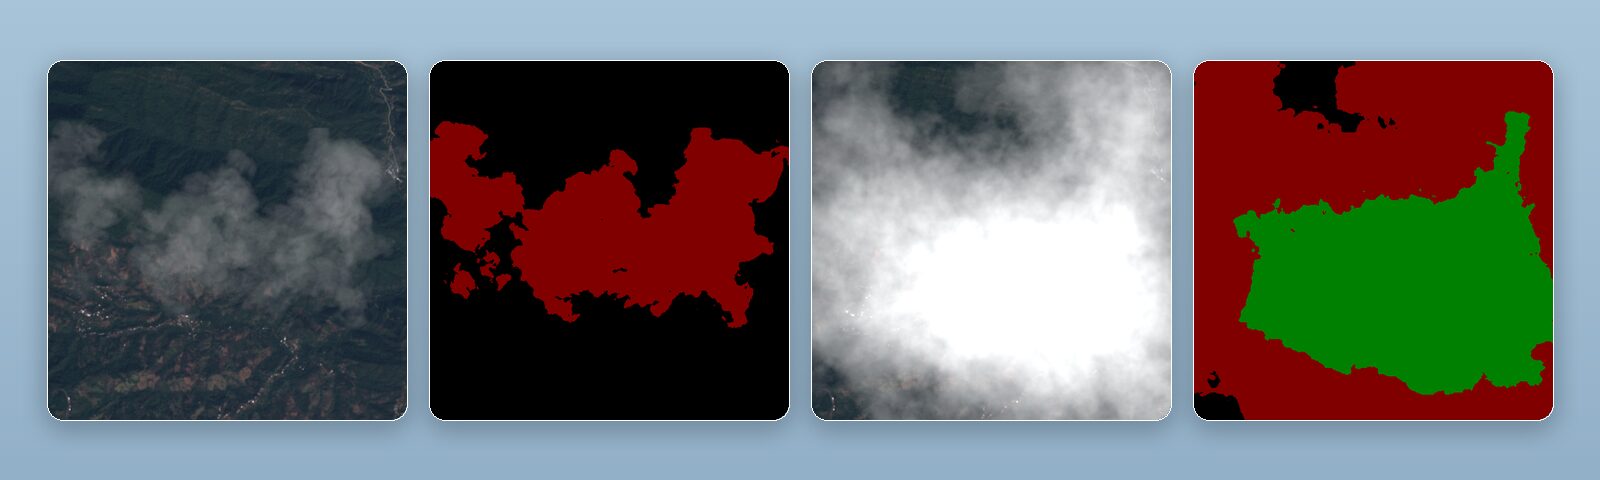
Esta é uma das áreas em que mais nos concentramos. Geramos dados sintéticos de nuvens criados especificamente para dominar a detecção de nuvens e treinar modelos de remoção de nuvens. Como criamos cada cena do zero, sabemos exatamente onde cada nuvem e sua sombra estão, incluindo cirros finos e névoa sutil, que são notoriamente difíceis de os modelos reconhecerem. Isso fornece máscaras perfeitamente precisas para treinar modelos de detecção.
De forma igualmente útil, podemos renderizar a mesma cena duas vezes: uma com nuvens e outra sem, como um par correspondente. Esse pareamento é quase impossível de obter em acervos reais, onde raramente se captura uma cena idêntica sob ambas as condições com verdade de terreno confiável. Com dados pareados, um modelo de remoção de nuvens tem um alvo limpo para o qual aprender, em vez de uma aproximação. O resultado são modelos que conseguem sinalizar, mascarar e reconstruir áreas obscurecidas com muito mais confiabilidade do que imagens isoladas permitiriam.
Modelos treinados com dados sintéticos podem funcionar no mundo real?
Sim, mas nunca por fé: um modelo treinado com imagens sintéticas só conquista confiança quando é medido contra dados reais — e há um motivo específico pelo qual esse teste pode ser aprovado. Essa foi a pergunta mais incisiva que recebemos, e com razão. Talvez seja a pergunta mais importante, porque dados sintéticos só valem alguma coisa se transferirem para a realidade.
A diferença entre dados sintéticos e reais tem um nome — a lacuna de domínio — e fechá-la é o núcleo do trabalho. Não presumimos que um modelo treinado com imagens geradas simplesmente terá bom desempenho em campo. Nós medimos. O desempenho é avaliado em imagens reais reservadas para teste, e a síntese é ajustada para que as propriedades estatísticas e físicas das nossas cenas correspondam ao que sensores reais produzem, desde características de ruído até resposta espectral.
Também somos honestos sobre o que são dados sintéticos. Eles são uma ferramenta, não um atalho em torno da realidade, e seu valor depende inteiramente da sua fidelidade. Dados sintéticos de baixa qualidade treinam modelos de baixa qualidade. Por isso tratamos a validação contra a verdade de terreno real como parte do processo, e não como algo secundário, e por isso os melhores pipelines geralmente combinam imagens sintéticas e reais. O objetivo nunca é convencer alguém de que dados sintéticos são mágicos. É mostrar, com medição, que um modelo de fato aprendeu o que precisa.
Onde isso é realmente útil?
Ao final de cada conversa, as perguntas geralmente ficavam mais práticas. A resposta curta é que dados sintéticos de observação da Terra ajudam em qualquer situação em que se precisa de um modelo robusto, mas não há imagens reais rotuladas suficientes para as condições que mais importam — o que, na prática, abrange muito mais áreas do que as pessoas esperam.
Na agricultura, isso significa treinar modelos para identificar estresse, doenças ou tipos específicos de cultura mais cedo e em condições mais variadas do que o acervo oferece. Em seguros e finanças, isso apoia a avaliação de risco e de danos para eventos que, por natureza, são raros. No domínio marítimo, ajuda a detectar e classificar embarcações, inclusive os casos incomuns que conjuntos de dados reais mal contêm. Na resposta a desastres, permite que equipes preparem modelos para enchentes, incêndios e danos estruturais antes que esses eventos aconteçam, em vez de correr atrás de dados durante eles.
A mesma lógica se aplica a defesa e segurança, monitoramento de infraestrutura e trabalhos climáticos. Onde o fator limitante é dado, e não ambição, imagens sintéticas ampliam o que é possível: mais casos de borda, conjuntos de treinamento mais equilibrados e testes confiáveis para situações perigosas, raras ou simplesmente ausentes do que já foi capturado. Esse é o fio condutor que conecta todos os usos que discutimos em junho.
Se o(a) senhor(a) nos fez uma dessas perguntas no último mês, agradecemos a conversa. Se tiver uma sexta que não abordamos aqui, é essa que mais gostaríamos de ouvir a seguir.